本文您將讀到:
- 暴力破解物理定律: 用白話易懂的方式拆解 Vera Rubin 平台的六大核心組件,直接帶您看懂2026 CES的 10個重點,在製程瓶頸下實現 5 倍的推理性能飛躍。
- 儲存革命的新戰場——ICMS 與 BlueField-4: NVIDIA 為何要親自跳下來做儲存?我們深入剖析全新的 ICMS (Inference Context Memory Storage) 架構與 BlueField-4 DPU 如何解決 AI 的「短期失憶」問題。
- 市場最大的誤解——「去線化」真相: 為什麼銅線不僅沒死,反而變得更貴、更難做?我們將破解市場對「去線化」的恐慌與誤解。
- 為您點出了【40+】公司,深入挖掘架構變革背後的產業變革(非投資建議)。帶您看見 44 層 Midplane 厚板、微米級散熱冷板、特規存儲 (ICMS) 以及 CPO 光學引擎這些受惠的關鍵零組件與材料。
想直接查看40+公司有哪些請直接點擊下方連結前往 Part2 下集: 👉 2026 CES NVIDIA Rubin 架構全拆解:從 ICMS 儲存革命到 BlueField-4,破解「Cableless 去線化」迷思;盤點台美股40+公司 - Part2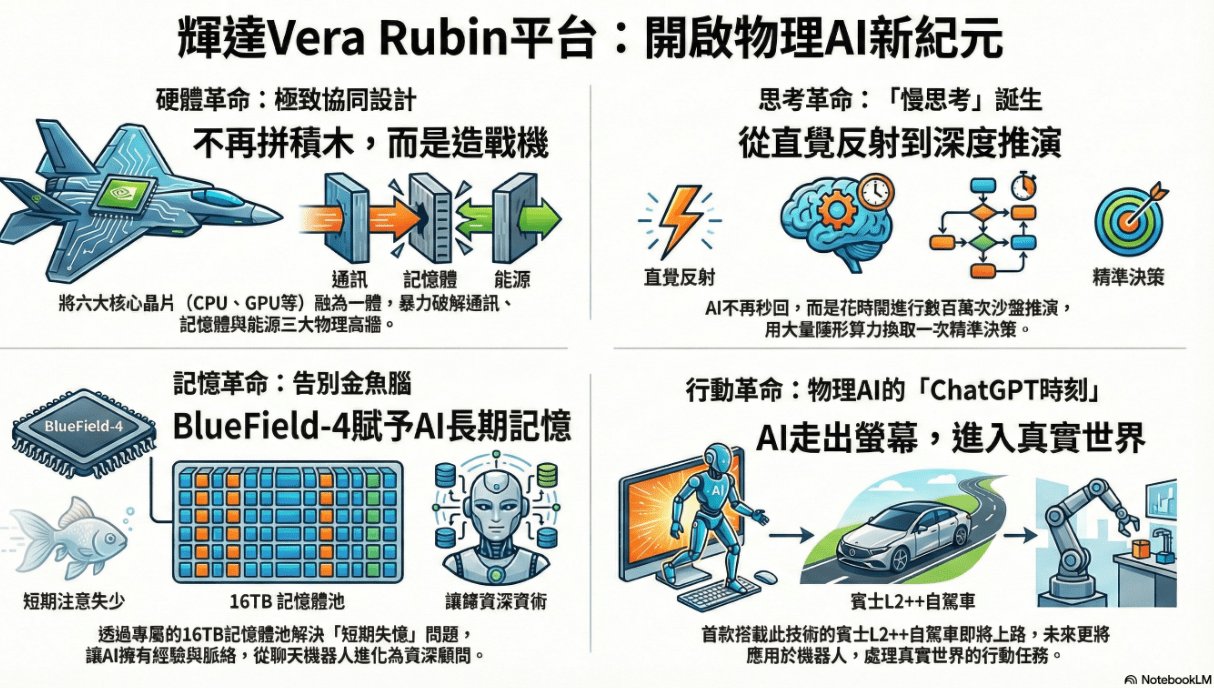
正文開始
時間是 2026 年 1 月 6 日,地點在拉斯維加斯的 CES 大會,NVIDIA 執行長黃仁勳不僅是發布了一款新晶片,他實際上是向整個半導體產業宣告了一件事:當摩爾定律這堵物理高牆擋在前面時,我們選擇把整面牆炸開。
這場演講的訊息量極大,所以我們這次的任務就是要為你簡單剖析這場演講,特別是這個全新的 Vera Rubin 架構,然後從裡面找出它接軌的未來趨勢,還有看看是否有潛在投資機會。
NVIDIA Rubin 平台並非單一晶片的升級,而是六大核心晶片的協同進化,旨在解決 AI 擴展中的通訊牆、記憶體牆與能源牆問題。該平台包含以下關鍵組件 :
組件名稱 | 關鍵規格與功能 | 技術亮點 |
|---|---|---|
NVIDIA Rubin GPU | 採用先進製程(預計為 TSMC 3nm),整合 8 層 HBM4 高頻寬記憶體 | 專為推理優化,支援 4nm NVFP4精度,推理性能提升 5 倍。 |
NVIDIA Vera CPU | 專為 AI 工作負載優化的處理器,與 GPU 緊密耦合 | 提供強大的主機處理能力,釋放 GPU 專注於張量計算。 |
NVLink 6 Switch | 第六代互連技術,實現超大規模的 GPU 統一記憶體定址 | 支援 3600 GB/s 的雙向頻寬,將 72 顆 GPU 連接成單一邏輯單元。 |
ConnectX-9 SuperNIC | 專為 AI 東西向流量設計的超高速網卡,支援 1600 Gb/s | 透過 PCIe Gen 6 介面,提供極致的網路吞吐量與低延遲。 |
BlueField-4 DPU | 演變為存儲與安全的核心樞紐,搭載 64 核 Grace CPU | 支援 ICMS 架構,作為 KV Cache 的卸載引擎,重新定義 DPU 角色。 |
Spectrum-6 Switch | 整合 Co-Packaged Optics (CPO) 的乙太網交換機 | 總頻寬達 51.2T 至 102.4T,透過光學引擎降低功耗與延遲。 |
1.物理定律撞牆?NVIDIA 的暴力解法:極端協同設計 (Extreme Codesign)
Vera Rubin 之所以重要,是因為它採用了一種叫做極致協同設計 (Extreme Codesign) 的理念。
過去造晶片就像造傳統客機:機身歸機身、引擎歸引擎,最後像「拼積木」般組裝。這種模式如今已撞上物理極限的高牆,再怎麼優化零件也無法突破。
於是,NVIDIA 掀翻桌子,改採「隱形戰機」的設計思維。這就像 B-2 轟炸機,引擎不再是獨立外掛,而是直接埋進機身,機翼本身就是進氣道。NVIDIA 將 CPU、GPU 等六款核心晶片徹底「融化」並重新鑄造,讓它們像有機生物體一樣,所以 Vera Rubin 它不再只是一塊 GPU,黃仁勳的目的是要打造一個超級運算平台。
Vera Rubin平台由6款核心晶片組成,包括搭載HBM4記憶體的Rubin GPU、擁有88個客製化Olympus核心的Vera CPU、第六代NVLink交換器、ConnectX-9網路卡、BlueField-4 DPU及Spectrum-X 乙太網路交換器
2. Vera CPU
那我們就把看看裡面到底藏了什麼玄機,裡面的細節我覺得非常有意思,首先映入眼簾的是運算心臟——Vera CPU。
過去,CPU 往往淪為 GPU 的配角,但這次不同。它搭載了革命性的「空間多執行緒 」技術,單顆晶片就能同時且高效地處理驚人的 176 個執行緒。
為了理解這個數字的意義,我們做個簡單的比喻:請將 Rubin GPU 想像成一座每秒產能爆表的超級工廠(負責極速運算),而傳統 CPU 就像是舊式的單線供貨卡車,往往讓工廠因為缺料而停擺。相比之下,Vera CPU 則是一座擁有 176 條高速輸送帶的「全自動智慧物流中樞」。它具備「三頭六臂」般的調度能力,唯一的任務就是進行飽和式供料,確保 GPU 這座超級工廠的生產線永遠被數據填滿,絕不容許出現任何一毫秒的閒置空轉。
3.NVLink 6 Switch : 讓 144 顆 GPU 實現「神經融合」
但真正的瓶頸往往在於晶片跟晶片的溝通速度,就像一個團隊裡最強的兩個人,如果沒辦法好好對話,效率也出不來,輝達是怎麼解決這個問題的?
這就是他們最可怕的技術出現的地方:NVLink 6 Switch。 它的核心數據暴力至極:總頻寬高達 240TB/s。240TB這個數字可能沒概念, 這個數字意味著,單單這一個機櫃內的交換節點,其每秒吞吐的數據量,竟是目前全球網際網路總流量的兩倍。這不只是速度的提升,而是對數據傳輸定義的降維打擊。它能讓多達 144 塊 GPU 在邏輯上像一塊無比巨大的超級 GPU 一樣思考和工作,中間幾乎沒有延遲。
4.Spectrum-X CPO : 打破「銅線發熱障壁」的光速革命
有了頂級的運算與調度,有快到不可思議的傳輸系統,那還有什麼?最後一個關鍵是最近很熱的話題:共封裝光學 (Co-Packaged Optics, CPO),如果對CPO與矽光子有興趣可以看到我們之前寫的相關文章內容👉CPO 矽光子革命全解析 - NVIDIA 與台積電都在賭的未來!一次看懂AI時代從技術到銅退光進的黃金十年
傳統的資料傳輸方式是用銅線,這就像在擁擠的城市裡開車走巷子又擠又慢,還會因為摩擦而發熱。CPO 呢則是直接在晶片的旁邊蓋了一條光纖超級高速公路,他把光引擎直接焊進晶片的封裝裡,數據直接以光子的形式在上面跑,幾乎沒有延遲和熱量損失,所以這不僅僅是為了快,更是為了省電,如果還用傳統銅線傳輸那麼大的數據量,產生的熱量足以直接燒毀整個機房。
至此,NVIDIA 完成了最後的垂直整合:從運算、記憶、傳輸到光學封裝。這已不只是晶片的對決,而是一場對整個物理生態系的全面接管。
5.電力與散熱
目前全球建設 AI 資料中心的最大瓶頸,已不再是晶片產能,而是電網負載。傳統的散熱方案就像一頭吞噬電力的怪獸,為了讓晶片保持冷靜,除了導入液冷散熱之外,資料中心必須運轉巨大的製冷壓縮機,強行將冷卻水降至 10-15°C。這過程本身就是在燃燒真金白銀。
面對這個物理與經濟的雙重困境,NVIDIA 給出的答案是一項沒有人想的到的技術:45°C 溫水冷卻技術。
這並非什麼魔術,而是對晶片耐熱性與熱交換效率的極致精算。對於採用全液冷架構的 Vera Rubin 而言,45°C 的水溫已足以帶走廢熱。
這看似微小的溫度調整,實則是移除了資料中心裡最耗電的——製冷壓縮機。
這帶來了兩大戰略價值的質變:
- 營運成本的重構: 拿掉壓縮機意味著直接削減了資料中心約 6% 的總能耗。對於吉瓦級(Gigawatt)的超級運算中心(如 Microsoft 或 Google)而言,這 6% 代表著每年數億美元的淨利潤釋放,是極具吸引力的 TCO(總擁有成本)優化。
- 基礎設施的選址解鎖: 這是更深遠的影響。許多城市並非沒有土地,而是電力配額已達上限。45°C 溫水冷卻大幅降低了電力門檻,讓 AI 算力中心得以進入那些原本因電力不足而被判死刑的地區。
6.Test-time Scaling :從「直覺反射」進化為「深度推演」
這麼強大的硬體究竟能讓 AI 本身產生什麼樣的質變?AI 的靈魂會因此進化嗎?這就帶到了演講的下半場,黃仁勳提到一個關鍵詞,思考時間擴展 (test-time scaling),通俗的說法就是慢思考。
那慢思考這跟我們現在用的 AI 有什麼不同?
這標誌著 AI 正式從「系統一(快思考)」跨越到「系統二(慢思考)」的領域。
為了理解這個質變,我們必須拋棄「AI 只是高階聊天機器人」的舊觀念。 目前的 ChatGPT(早期版本)運作模式更像是一種「機率性的直覺反射」。
當你問它問題,它依賴的是大數據訓練出的統計關聯,就像人類的膝跳反應一樣,瞬間吐出一個機率最高的答案。這中間並沒有真正的「推理」。
但 2026 年的 AI,學會了「謀定而後動」。
當你丟給它一個複雜任務,例如「為我的新創公司規劃三年上市策略」,它不再急著秒回。相反地,它會啟動強大的後台推理引擎,進入一種「虛擬沙盤推演」的狀態。
在這個你看不到的幾秒鐘(甚至幾分鐘)延遲裡,AI 正在進行成千上萬次的思維鏈辯證。它在自我反思、模擬市場變數、駁回錯誤路徑、並重新修正邏輯。
最終,呈現在你面前的可能只有一張 A4 紙的精準策略。但在這張紙的背後,AI 的大腦內部可能已經生成並銷毀了上百萬字的思考草稿。這就是「慢思考」的真諦——用大量的隱形算力,換取一次精確的決策。
7.算力提升與成本下降
這就直接回到了很多投資者的擔憂,等這些大模型都訓練完之後,還需要那麼多顯卡幹嘛?
黃仁勳的答案是訓練只是開始,真正的算力消耗是接下來 AI 的每一次思考,數據顯示,這不僅僅是升級,而是跨代跳躍。
與前代霸主 Blackwell 相比,Rubin GPU 在訓練效能上提升了 3.5 倍,而在更關鍵的推論效能上更是暴漲了 5 倍。這兩個數字的差異(5 > 3.5)再次印證了 NVIDIA 的戰略轉向:未來的戰場重心,已從「訓練」轉移至「應用」。
如果 AI 每進行一次深度思考的成本高昂,那麼所謂的 AI 代理人 (AI Agent) 就只能停留在實驗室裡,無法成為可獲利的商業產品。畢竟,沒有企業會僱用一個比真人還昂貴的數位員工。
這正是 Vera Rubin 存在的終極意義——將 AI 推理成本暴力壓縮 10 倍。
而在科技史上 10 倍的成本降低,通常都會引發一場革命。
回顧過去三十年:
- 通訊成本下降 10 倍(光纖普及): 讓資訊傳輸趨近零成本,推平了國界,誕生了 Google 與全球化網際網路。
- 頻寬成本下降 10 倍: 讓數據傳輸不再昂貴,文字轉向影片,催生了 YouTube 與 Netflix 的影音帝國。
- 儲存成本下降 10 倍: 讓我們不再擔心硬碟空間,奠基了 AWS 與 iCloud 的雲端時代。
根據 NVIDIA 公佈的數據,Vera Rubin 可以用四分之一的硬體規模,在同樣時間內完成頂級 AI 模型的訓練。而最重要的是生成每一個 AI 回覆的成本 (Token 成本) 降低到只有原來的 1/10。
8.Bluefield-4 DPU ,本場演講重點
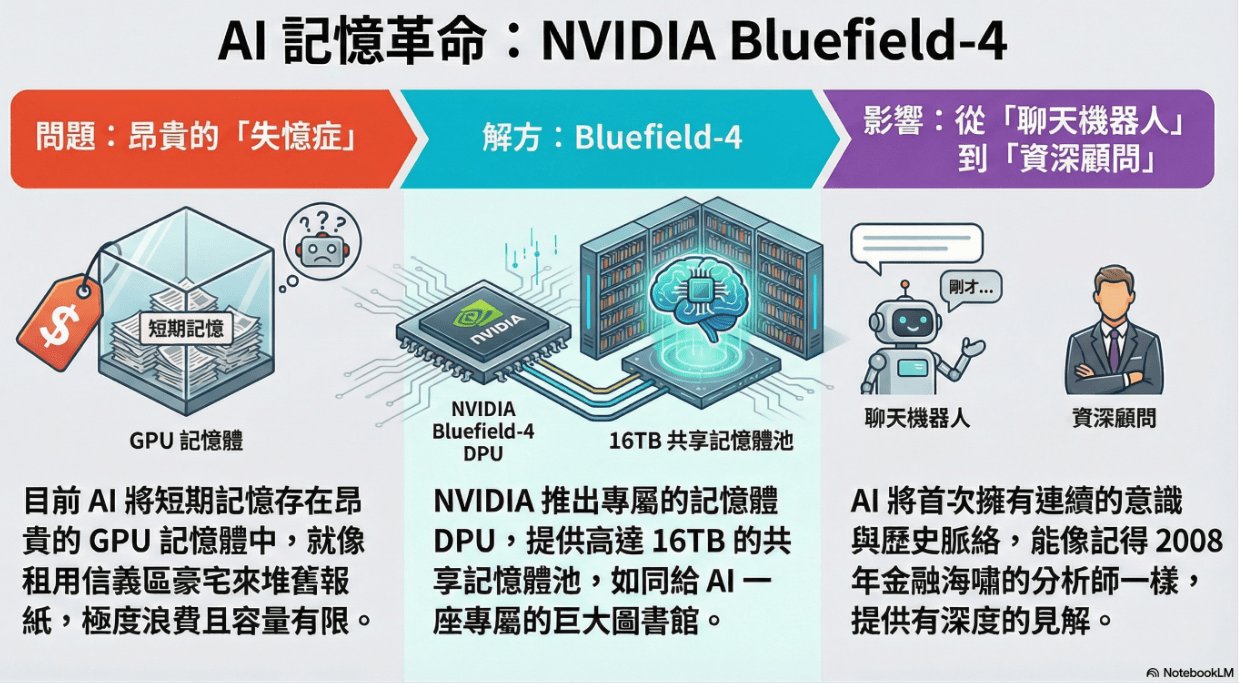
一個會思考,而且成本低廉的數位勞動力,聽起來很棒,但光會思考還不夠。我個人有個很大的痛點,就是現在的 AI 記性太差了,有時候跟他聊了半小時,精心設定了一堆背景,結果問他五分鐘前我們說過什麼,他居然就忘了,這種感覺太讓人洩氣了,不知道讀者們有沒有這樣的感覺? 這在技術上被稱為「記憶體牆 (Memory Wall)」,具體來說是 KV Cache 的瓶頸。 傳統架構下,AI 必須把對話的上下文(短期記憶)硬塞進 GPU 核心那塊 HBM (高頻寬記憶體) 裡。
但問題在於,HBM 是晶片界最昂貴的資源,寸土寸金。 用昂貴的 HBM 來存儲冗長的歷史對話紀錄,就像是租了台北信義區的頂級豪宅,卻只是為了拿來堆放過期的舊報紙,這在經濟效益上是極度荒謬的。一旦「房間」滿了,AI 為了騰出空間,就只能被迫把舊報紙(你的前文)丟掉。
NVIDIA 的解法:給 AI 一個專屬的「圖書館」
黃仁勳不打算讓 AI 繼續住在豪宅裡堆報紙,他的策略是改變架構。 NVIDIA 推出了 Bluefield-4 DPU,你可以將它視為掛載在 GPU 旁、專門負責記憶管理的「數位圖書館」。
它提供了一個高達 16TB 的共享記憶體池。為了讓你對這個數字有感,我們換個商業視角:
- 16TB 不再只是幾本書,它足以裝下 S&P 500 企業過去 30 年來所有的財報、法說會逐字稿以及分析師報告
- 或者,它能完整儲存一家科技公司從創立至今所有的程式碼庫、所有的電子郵件往來、以及每一次產品會議的錄音檔。
這意味著 AI 的「意識」將第一次實現連續性。
想像一下,未來的投資助手不再是只能幫你總結單篇新聞,而是一個記得2008 年金融海嘯前夕市場所有細微徵兆,並能與當下局勢做即時比對的資深分析師。
或者一個研發單位的 AI 協作員,它不再只是寫 Code 的工具,而是記得五年前某位已離職工程師為什麼要這樣設計架構的「活體知識庫」。
Bluefield-4 的出現,解決了從「聊天機器人」進化到「資深顧問」最關鍵的一哩路:它讓 AI 擁有了我們最珍貴的資產、經驗與脈絡。
9.Physical AI:走出螢幕, ChatGPT 時刻
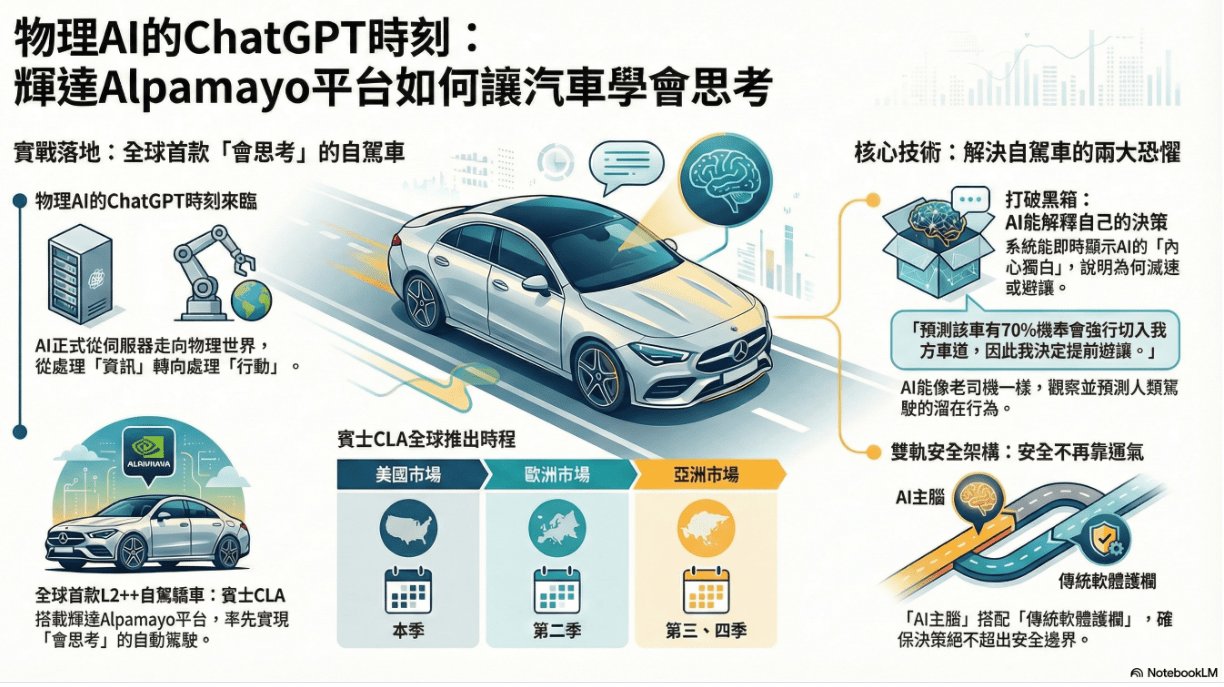
到目前為止,我們得到了一個超強大、超省電、會思考,而且記性超好的 AI,但他好像還被困在伺服器裡,他什麼時候才能真正走出來到我們的物理世界裡動手做點事?這就是黃仁勳演講的最高潮,他稱之為物理 AI 的 ChatGPT 時刻這意味著 AI 的戰場從處理資訊(文字/圖片),正式轉向處理行動 (Action)。輝達正式宣布推出 Alpamayo 自駕車平台,攜手賓士等車廠,宣告完成開發會「真正思考」的自駕大腦。
實戰落地:全球首款 L2++ 賓士 CLA 本季上路
這不是遙遠的科幻夢,而是明確的投資時間表。 黃仁勳宣布,賓士將率先導入此平台於 CLA 車系,這將是全球第一台 L2++ 全自駕轎車。
- 美國市場: 本季(Q1)正式上路。
- 歐洲市場: 緊接著於第 2 季上路。
- 亞洲市場: 預計第 3、第 4 季進入。
這意味著,輝達的營收結構中,車用軟體授權金將在今年開始貢獻實質現金流。
核心技術:Alpamayo 的「內心獨白」與雙軌安全架構
Alpamayo 最令人震撼的突破,在於它解決了自動駕駛界長久以來的兩大恐懼——「黑箱問題」與「安全信任」。
1. 打破黑箱:它能解釋決策 過去的車子急煞時,工程師答不出原因。但在 CES 展示中,當車輛在路口減速時,後台螢幕即時顯示出一段像人類一樣的對話框:
偵測與觀察:左前方藍色轎車煞車燈亮起,且前輪出現向右5度的偏轉,推理與預測: 根據駕駛行為模型,該車有 70% 機率會在【沒有打方向燈】的情況下【強行切入我方車道】。
決策執行: 所以為確保安全邊際,我決定提前釋放油門並微幅向右避讓,預留緩衝空間。
這顯示 AI 已經學會像老司機一樣,去閱讀物理世界的因果邏輯與人類的潛規則。
2. 雙軌安全架構 :安全不再靠運氣為了確保絕對安全,每輛車皆配備冗餘感測器,並採用了特殊的「雙軌制」:
- 主軌(AI 腦): 由 Alpamayo 執行高階自主決策與推理。
- 護欄(傳統腦): 輔以一套完全可追溯、可驗證的傳統自動駕駛軟體堆疊作為安全防護網。
系統會動態判斷路況,一旦 AI 決策超出安全邊界,系統會瞬間切換至保守模式。這套設計讓賓士 CLA 成為全球唯一從晶片、系統到每一行程式碼都通過嚴格安全認證的車款。
未來願景:從車到機器人
黃仁勳強調,這套架構是通用的。它採用專為機器人設計的雙處理器架構,並整合了端到端模擬與合成資料生成。這套「大腦」同樣適用於移動型機器人、機械手臂甚至人形機器人。
輝達甚至開放了這項工具,讓潛在用戶可以用 Alpamayo 模型自行再訓練,創造出能設法擺脫突發狀況(如交通號誌故障)的機器。
正如黃仁勳在結尾所描繪的願景:「想像有一天,路上會有 10 億輛車都能自動駕駛。」 而這一切的起點,就是 2026 年的現在。
10.Omniverse 與 Cosmos:用「平行宇宙」破解數據稀缺的終極護城河
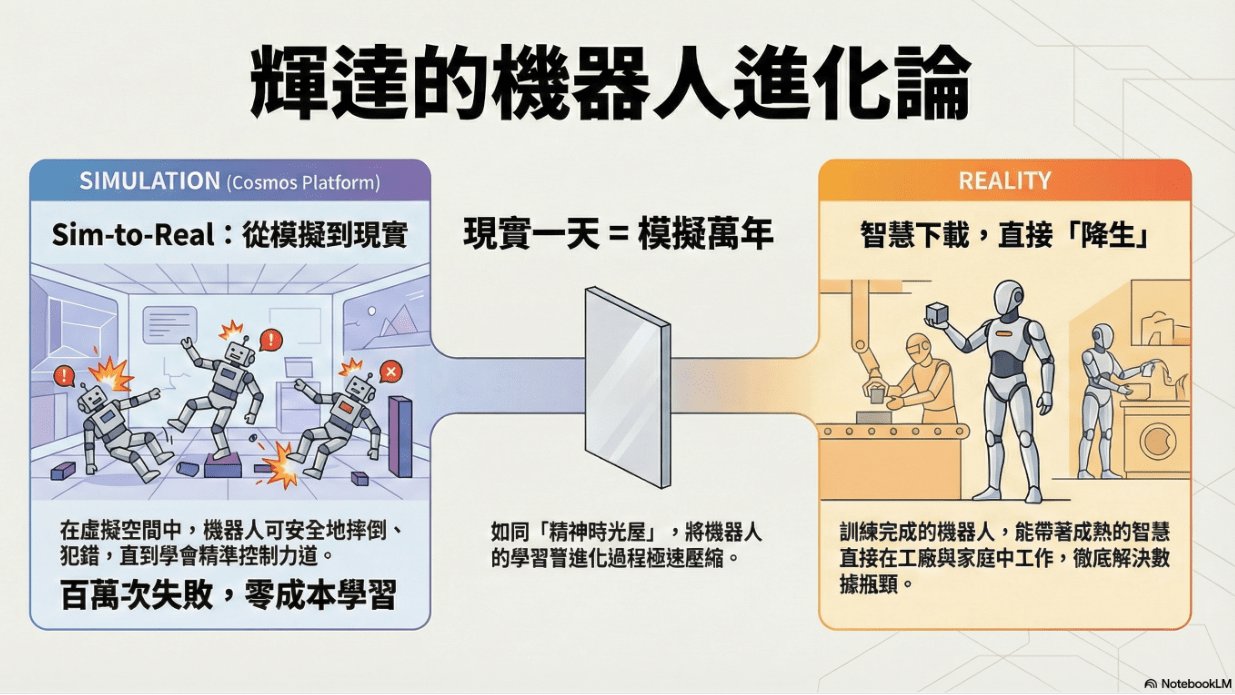
除了自動駕駛開車還有機器人訓練,而這也是輝達恐怖的技術護城河Omniverse平台,要在現實世界裡一個一個的訓練機器人既緩慢又昂貴,而且很危險。
輝達的做法是用一個叫做 Cosmos 的世界模型,在雲端生成一個跟我們現實世界物理規則一模一樣的虛擬空間,然後把成千上萬個機器人放進這個虛擬世界裡,讓他們 24 小時不斷地在裡面學習和訓練,所以這就像七龍珠的精神時光屋一樣,現實世界過了一天,在 Omniverse 裡他們可能已經過了幾十年,甚至幾百年現實中的一天在 Omniverse 裡可以模擬出 1 萬年的訓練量,機器人在裡面摔倒了 1000 萬次,終於學會了如何平衡;打破了 1000 萬個虛擬碗盤,終於學會了精準控制力道,等他們練成可以跟正常人一樣的生活,再把學成的模型下載到現實世界裡,放進機器人的大腦中,這就是所謂的從模擬到現實,它徹底解決了機器人領域最大的數據獲取瓶頸。
這就是業界夢寐以求的 Sim-to-Real (從模擬到現實) 技術。 它徹底解決了機器人發展最大的瓶頸。NVIDIA 證明了:未來的機器人不需要在現實中慢慢長大,它們可以在虛擬世界中完成幾千年的進化,然後帶著成熟的智慧直接「降生」到我們的工廠與家庭中。
黃仁勳已經畫出了 Vera Rubin 的宏偉藍圖,宣告了物理 AI 時代的來臨。但對於投資人來說,真正的問題才正要開始:
- 當市場因為聽到 "Cableless" 而恐慌拋售線束股時,真相究竟是什麼? 我們發現銅線並沒有消失,而是變成了更昂貴、技術門檻極高的 44 層 Midplane 背板。
- 當大家以為 SSD 是紅海市場時,NVIDIA 為什麼要親自跳下來做 ICMS?
- 當晶片堆疊層數越來越高,哪幾家檢測設備商正悄悄迎來比晶圓廠更長的超級循環?
我們結合了市場上的資訊,為您鎖定了 40+ 公司, 橫跨台美日韓的廠商。
👉 下集:2026 CES NVIDIA Rubin 架構全拆解:從 ICMS 儲存革命到 BlueField-4,破解「Cableless 去線化」迷思;盤點台美股40+公司 - Part2
參考資料來源
- Nvidia 官方網站
- Morgan Stanley報告