本文您將讀到
- Google 黑科技引發的真相:深度並白話解析 TurboQuant 演算法本質,為何壓縮 KV Cache 是 DRAM 的事,市場卻連 NAND 儲存股一起拋售?
- 打破「效率提升=需求減少」的恐慌迷思:為何 AI 運算變便宜,反而會讓記憶體消耗總量呈現指數級噴發!
- 南亞科 (2408.TW) 10 億美元私募案:為何做網通的 Cisco (#CSCO)、做快閃記憶體的 SanDisk (#SNDK),要砸千億搶投資市佔僅 2% 的老廠?
- 投資策略定錨:在 AI 投資的修羅場中過濾敘事雜音,看懂巨頭們的產能焦慮,如何讓記憶體正式升級為戰略物資。
前言
這幾天,如果你手上有記憶體相關的持股(如美光 #MU、威騰 #WDC、SK 海力士等),可能經歷了一場莫名其妙的驚嚇。
美光 (#MU) FY2Q26 財報評析:毛利率上看 81%!AI 引爆記憶體戰略物資時代,首度簽下「5 年長約」背後的 AI 產能焦慮
市場上突然颳起了一陣「敘事逆風」:Google 發布了 TurboQuant 壓縮演算法技術。這項技術號稱能將 KV Cache(鍵值快取)的記憶體佔用空間大幅縮減 6 倍,並讓 H100 GPU 的推論速度提升 8 倍。
文獻參考:TurboQuant:以極致壓縮重新定義人工智慧效率
新聞一出,市場群眾馬上聯想到:「哇!記憶體用量可以省 6 倍?那以後誰還要買 DRAM?記憶體大廠準備完蛋了!」然後,不管三七二十一,先把記憶體股票倒貨再說。
但事實真的是這樣嗎?就在散戶被演算法新聞嚇得拋售持股時,科技巨頭們卻正在真實的商業世界裡,上演一場產能搶奪戰。
讓我們戴上客觀分析的眼鏡,從最新的重磅新聞,拆解這波錯殺的荒謬邏輯。
官方解密:什麼是 TurboQuant?它到底施了什麼魔法?
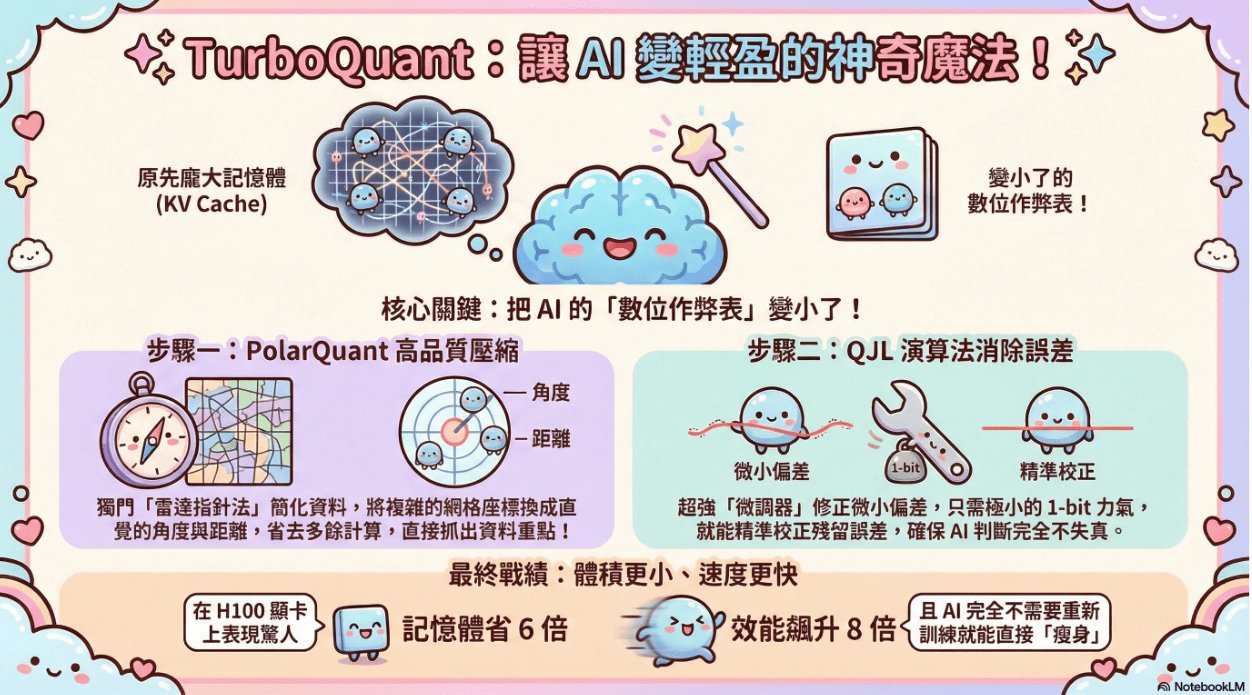 根據 Google Research 團隊發布的最新報告,TurboQuant 是一套先進的量化演算法,專為大型語言模型和向量搜尋引擎提供大規模的壓縮能力。AI 模型在處理資訊時,高度依賴高維度向量,但這會消耗大量的記憶體,導致「鍵值快取(Key-Value Cache,簡稱 KV Cache)」出現嚴重瓶頸。KV Cache 就像一個高速的「數位作弊表(digital cheat sheet)」,能儲存常用資訊,讓電腦瞬間檢索而無需搜尋緩慢的龐大資料庫。TurboQuant 的出現,就是在完全不損失準確度的情況下,解決這個記憶體開銷問題。它主要透過兩個關鍵步驟來達成極致壓縮:
- 第一步:高品質壓縮(PolarQuant 方法)
- TurboQuant 首先會隨機旋轉資料向量,藉此簡化資料的幾何結構。
- 接著,PolarQuant 會將向量從標準的笛卡兒座標轉換為「極座標」系統。這就像是把「往東走 3 個街區、往北走 4 個街區」的指令,替換成「以 37 度角走 5 個街區」。將資料映射到固定的圓形網格上,免去昂貴的資料正規化步驟,消除傳統量化方法的記憶體開銷。
- 因為角度的模式是已知且高度集中的,這使得資料能映射到固定的「圓形」網格上,從而免去了昂貴的資料正規化步驟,並消除了傳統量化方法必須承受的記憶體開銷。這階段會使用大部分的壓縮能力來捕捉原始向量的主要概念與強度。
- 🗣️ 一句白話秒懂 PolarQuant:
簡單來說,這就像是把電腦原本複雜的報路法(向東走 3 步、向北走 4 步)」,改成更直覺的「雷達指針法(朝 37 度角直接走 5 步)」;因為方向和距離變得固定且好預測,電腦就不必再額外浪費記憶體去處理複雜的網格計算,直接就能抓出資料的核心重點!
- 第二步:消除隱藏誤差(QJL 演算法)
- 在第一階段後,TurboQuant 會利用極小的一部分壓縮能力(僅 1 個 bit),套用 Quantized Johnson-Lindenstrauss (QJL) 演算法來處理殘留的微小誤差。
- QJL 階段相當於一個數學的誤差校正器,能消除偏差,讓最終的注意力分數(attention score)更加準確。
- 🗣️ 一句白話秒懂 QJL 演算法:
這就像是一個超級微調器;在剛剛用雷達指針法抓出大方向後,系統只用極小的力氣,就能把剩下那一點點的微小誤差給精準校正回來,確保 AI 的判斷完全不失真。
這項技術的具體戰績非常驚人:它能在不需要重新訓練或微調的情況下,將 KV Cache 量化至僅 3 bits,並將 KV 記憶體容量縮減至少 6 倍。此外,在 H100 GPU 加速器上,4-bit 的 TurboQuant 甚至能比 32-bit 的未量化金鑰提升高達 8 倍的效能。
富程觀點—市場的錯殺
Google 的技術確實令人驚豔,在了解了技術本質,我們來看看為什麼這波殺盤邏輯需要重整一下,點出其中三個盲點:
盲點一:把 DRAM 和 NAND 混為一談
如同 Google 報告所述,TurboQuant 壓縮的是KV Cache。在硬體的物理架構中,KV Cache 主要常駐在 GPU 的 HBM 或 GDDR 裡;如果 GPU 撐不住了,才會 Offload(卸載)到 CPU RAM 裡。只有在處理超級巨大的 Context(上下文)或極度冷門的資料時,才有機會跑到底層的 SSD(NAND Flash)。也就是說,這個演算法主要是針對 DRAM 的優化,
根本不關 NAND 儲存的事!
但市場卻因為這則新聞,把 NAND 相關股票也一起跟著丟下去。這就是近期市場感到恐慌的地方,恐慌一來,管你是算力還是儲存,先賣再說。
當然不排除其他賣股票的原因,只是針對此事件來做推導。
盲點二:成本降低會導致使用量增加,而不是減少。
演算法永遠會變得更有效率,就像去年的Deep Seek一樣,但這並不會取代記憶體或 GPU 的物理存在。它可能會在結構上微幅降低單一任務的 DRAM 需求。
但當資源使用效率提高、成本下降時,反而會激發出指數級增長的新應用場景。單一任務省下的記憶體,會被成千上萬個新冒出來的 AI 任務瞬間吃光。
關鍵術語解釋
為了讓你更好懂,這段話涉及幾個 AI 運算的硬核心技術:
• KV Cache: AI 在對話時,為了「記得」你前面說過的話,會把之前的資訊存在記憶體裡。對話越長,KV 快取佔用的記憶體就越多。
• TurboQuant / Compression(壓縮技術): 這是一種把數據變小的技術。
外行的看法: 數據變小了 → 記憶體用量變少 → 記憶體公司(美光、海力士)利空。
富程的看法: 數據變小 → 省下的空間可以讓 AI 一次讀更多書、聊更長的內容(擴大上下文) → 使用者會更瘋狂地使用 AI → 最終消耗總量反而更多。
• Cost per Token(每個字元的成本): AI 運算變便宜,會刺激需求。
盲點三:真正的受惠者在邊緣運算 (Edge AI)
這項技術的突破,與其說是對資料中心 DRAM 的利空,不如說是對 ARM 架構與終端設備(AIPC、AI 手機)的超級利多!因為它讓 AI 模型更容易在本地端(Local)順暢運行,加速 AI 落地到你我的設備中。
現實狀況:散戶在拋售,巨頭卻在砸千億買「保單」
如果 Google 的演算法真的會讓記憶體需求消失,那以下這則新聞就完全無法解釋了。
就在市場看壞記憶體時,台灣記憶體廠南亞科 (2408.TW) 連發公告,宣布完成大規模私募案,引進了四家國際大廠:SanDisk(晟碟 #SNDK)、Kioxia(鎧俠)、Solidigm(SK海力士旗下)、以及 Cisco(思科 #CSCO)。
這份名單非常詭異:SanDisk 與鎧俠是做快閃記憶體的,Cisco 是做網通設備的,Solidigm 身為全球最大 DRAM 廠之一 SK 海力士的子公司,竟然跑去投資自家母公司的競爭對手?更何況,南亞科的全球市占長期徘徊在 2~3% 之間,主力還是舊世代的 DDR4。
為什麼這些科技巨頭,要拿大把現金去投資一個市佔僅 2% 的小廠?
AI 改變了遊戲規則,成熟製程成了「稀缺資產」
AI 伺服器對 HBM(高頻寬記憶體)的需求進入指數級成長。三大廠(海力士、三星、美光)幾乎全數把先進產線轉向 HBM 和 DDR5,供應 AI 伺服器的優先度遠高於一切。
但世界上還有大量的設備(企業級 SSD、網路交換器、工控系統)在跑 DDR4。當三大廠資源向 HBM 傾斜,到了 2027 年,全球能穩定量產 DDR4 的,大概只剩南亞科 (2408.TW) 和華邦電(2344.TW)。
買的不是股票,是「不用擔心斷貨的確定性」
這四案私募都有一個共同結構:入股同時附帶長期 DRAM 供應協議,且綁定三年鎖定期。
以 SanDisk 為例,它花了約 10 億美元(近 310 億台幣)取得南亞科 3.9% 股份。SanDisk 實際買的可能不是南亞科未來的財務分紅,而是拿 10 億美元買一份「記憶體供應的確定性」。
這就像是超市開業前,供應商先出資入股,條件是未來幾年必須給予固定的上架空間。
過去科技業的核心邏輯是誰技術最強,誰最值錢。但 AI 改變了這個假設,「供應鏈安全」已經變成比技術水準更根本的優先議題。 在 DRAM 供給緊缺的時代,能簽到長期供應協議,本身就是一種無法用錢直接在現貨市場買到的業務護城河。
結論
總結來說,Google 的 TurboQuant 是一項偉大的軟體工程突破,但它對記憶體產業的影響,「感覺更像是一陣敘事的逆風,而不是對實質盈餘(Earnings)的打擊。」
在 AI 投資的修羅場裡,與其每天盯著 Google 又出了什麼讓運算更有效率的演算法而自己嚇自己,我們真正該關注的主指標,永遠是 Hyperscaler(雲端巨頭)的資本支出(CapEx)預測。
擔心演算法會讓客戶不買記憶體嗎?
想一想:如果連買低階 DDR4 的 Cisco、SanDisk,都已經恐慌到要砸 10 億美元入股來「買產能保單」;那麼極度渴求頂規 HBM 與高階 DRAM 的微軟、Google、Meta,會有多焦慮?
這完美解釋了全球第三大記憶體廠 美光 (#MU) 剛剛交出亮眼的財報!大型CSP不但沒有因為演算法而減少採購,反而因為怕買不到,首度捧著現金跟美光簽下長達 5 年的 SCA 戰略長約,甚至讓美光下一季的毛利率指引直接衝上駭人的 81%!
記憶體早就不是過去那個隨便殺價的大宗商品,而是 AI 軍備競賽中真正的「戰略物資」。
想知道這 81% 暴利背後的真相?想了解美光 250 億美元的資本支出到底在盤算什麼?點擊下方連結,閱讀富程觀點的完整深度解析,帶你從法人的內部模型與估值區間,看懂這波錯殺背後的黃金佈局點!
👉美光 (#MU) FY2Q26 財報評析:毛利率上看 81%!AI 引爆記憶體戰略物資時代,首度簽下「5 年長約」背後的 AI 產能焦慮
參考資料: